Dies ist die vierte Folge einer Reihe auf diesem Blog, die sich mit KI-Grundlagen im Zusammenspiel mit SAP Business One beschäftigt. Bisher ging es vor allem um das, was ein Sprachmodell lernt, bevor es überhaupt zum Einsatz kommt: Bewertungen durch Menschen, mehrfaches Ausprobieren, das schrittweise Prüfen von Zwischenergebnissen. Diese Folge dreht die Perspektive um. Es geht um das, was passiert, während ein Modell bereits arbeitet, ein Werkzeug benutzt oder Code ausführen lässt, und wie es auf das reagiert, was dabei tatsächlich herauskommt. Zwei Verfahren stehen im Zentrum, die ähnlicher klingen, als sie tatsächlich sind: ReAct und RLEF.
Weiterlesen: ReAct und RLEF: Wie Künstliche Intelligenz aus echten Fehlern lernt — und was der automatische Bankabgleich in SAP Business One damit zu tun hat.
Reagieren ist nicht dasselbe wie Lernen
Ein KI-Agent, der einen Fehler bemerkt und ihn im nächsten Versuch nicht wiederholt, wirkt wie gesunder Menschenverstand.
Tatsächlich wiederholt genau derselbe Agent den Fehler in der nächsten Sitzung trotzdem, und zwar zuverlässig. Das Nicht-Wiederholen gilt nur innerhalb der einen laufenden Aufgabe. Sobald die Aufgabe beendet ist, weiß das Modell wieder genauso wenig wie vorher.
Für ein Unternehmen, das über KI-gestützte Automatisierung nachdenkt, ist das kein akademisches Detail. Beleg-Bots, Coding-Assistenten, Support-Agenten werben inzwischen fast alle mit demselben Satz: “Das System lernt aus seinen Fehlern.” Der Satz stimmt fast immer, nur meint er selten dasselbe.
Ein Beispiel macht den Unterschied greifbar
Ein Coding-Assistent, der innerhalb einer Sitzung einen Syntaxfehler korrigiert, wirkt lernfähig. Öffnet man am nächsten Tag eine neue Sitzung mit einer ähnlichen Aufgabe, macht er exakt denselben Fehler erneut. Das ist kein Defekt, sondern schlicht ein anderes Verfahren als das, was landläufig unter “die KI lernt dazu” verstanden wird.
Die Frage ist deshalb keine rein technische. Wer eine wiederkehrende Automatisierung einführt, etwa für Belegprüfung oder Zahlungsabgleich, verlässt sich stillschweigend darauf, dass Fehler mit der Zeit seltener werden. Ob das tatsächlich passiert, hängt genau davon ab, welches der beiden hier behandelten Verfahren im Hintergrund arbeitet.
Ein Beispiel aus SAP Business One gibt es auch hier wieder: Ein deterministischer Mechanismus, der genau an dieser Schwelle steht, zwischen bloßem Reagieren und echtem Dazulernen. Wo er auf dieser Schwelle tatsächlich steht, klärt sich weiter unten.
Ein neuer Mitarbeiter mit Kurzzeitgedächtnis
Stellen Sie sich einen neuen Mitarbeiter vor, der eine unbekannte Aufgabe bekommt und laut mitdenkt. Er überlegt, was zu tun ist, probiert einen ersten Schritt aus und schaut sich das Ergebnis an. Danach richtet er den nächsten Schritt entsprechend aus. Bis zum Feierabend hat er die Aufgabe gelöst, mit ein paar Umwegen, aber am Ende richtig.
Am nächsten Morgen bekommt derselbe Mitarbeiter eine ähnliche Aufgabe. Er fängt wieder bei null an. Nicht, weil er ungeschickt wäre, sondern weil ihm niemand explizit beigebracht hat, was er sich am Vortag mühsam erarbeitet hat. Das Mitdenken von gestern war real, es hat nur keine Spur hinterlassen.
Genau dieses Muster, in zwei unterschiedlichen Varianten, steht hinter den beiden Verfahren, um die es in diesem Text geht. Das eine gleicht dem Mitarbeiter am selben Tag: ein Modell handelt, beobachtet, passt den nächsten Schritt an, alles innerhalb einer einzigen Aufgabe. Das andere sorgt dafür, dass tatsächlich etwas übrig bleibt, wenn der Tag vorbei ist.
Denken, Handeln, Beobachten, und was danach übrig bleibt
Beide Verfahren haben eigene Namen bekommen: ReAct und RLEF. Beide drehen sich um denselben Grundbaustein, eine Aktion, ein Ergebnis aus der realen Welt, eine Reaktion darauf. Wie dieser Baustein in beiden Fällen konkret aussieht, unterscheidet sich deutlich.
Der ReAct-Loop
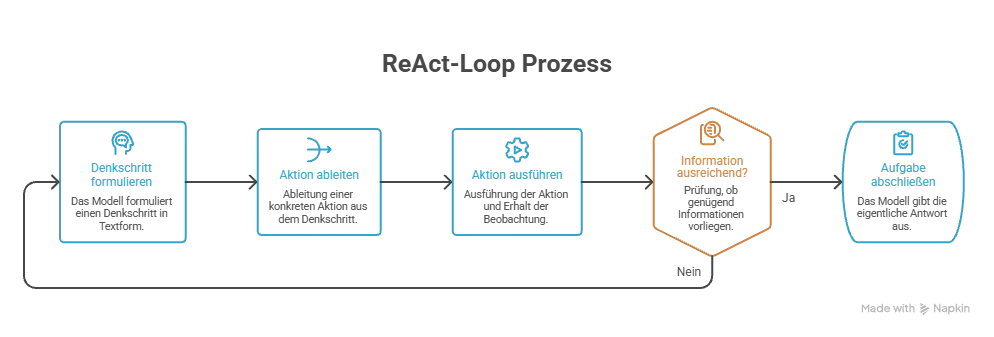
ReAct steht für “Reasoning and Acting”, zu Deutsch etwa Schlussfolgern und Handeln. Das Verfahren verzahnt verbale Denkschritte mit konkreten Aktionen, statt beides getrennt zu behandeln. Ein Modell bekommt eine Aufgabe oder Frage und arbeitet sie in einer Schleife ab.
- Das Modell formuliert einen Denkschritt in Textform, zum Beispiel welche Information als Nächstes fehlt.
- Aus diesem Denkschritt leitet es eine konkrete Aktion ab, etwa eine Suchanfrage an eine externe Quelle.
- Die Aktion wird ausgeführt, und das Ergebnis kommt als Beobachtung zurück in den Prompt.
- Auf Basis dieser Beobachtung formuliert das Modell den nächsten Denkschritt, und die Schleife beginnt erneut.
- Sobald genug Information vorliegt, schließt das Modell die Aufgabe mit der eigentlichen Antwort ab.
Wichtig ist, was in dieser Schleife nicht passiert: Es findet kein Training statt. Jede Beobachtung landet lediglich als zusätzlicher Text im laufenden Prompt. Sobald die Aufgabe beendet ist, verschwindet dieser Text wieder, und mit ihm alles, was das Modell währenddessen herausgefunden hat.
Der RLEF-Loop
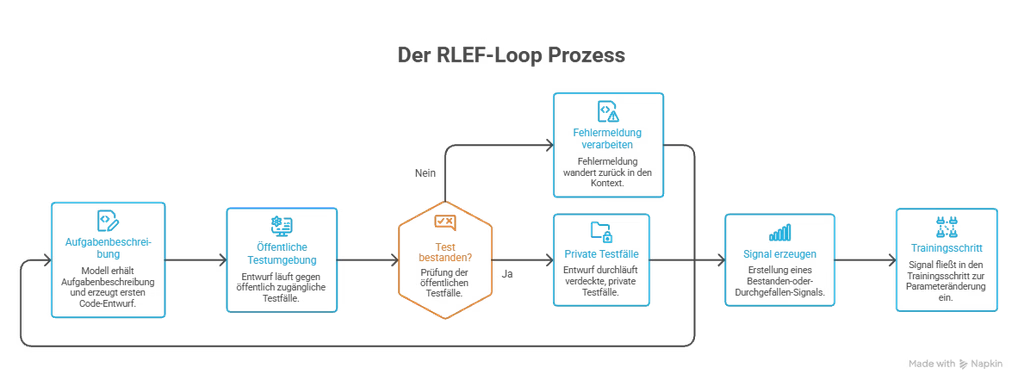
RLEF steht für Reinforcement Learning from Execution Feedback, Verstärkungslernen aus Ausführungsfeedback. Das Verfahren kommt aus der Softwareentwicklung und verbessert ein Modell im Umgang mit Code dauerhaft, nicht nur innerhalb einer einzelnen Aufgabe.
- Das Modell erhält eine Aufgabenbeschreibung in natürlicher Sprache und erzeugt einen ersten Code-Entwurf.
- Der Entwurf läuft in einer Testumgebung gegen öffentlich zugängliche Testfälle.
- Schlägt ein Test fehl, wandert die genaue Fehlermeldung zurück in den Kontext, und das Modell erzeugt einen neuen Entwurf.
- Ein bestandener Entwurf durchläuft zusätzlich verdeckte, private Testfälle, die während der Erzeugung nicht sichtbar waren.
- Aus dem Ergebnis dieser privaten Tests entsteht ein einfaches Bestanden-oder-Durchgefallen-Signal.
- Dieses Signal fließt in einen echten Trainingsschritt ein, der die Parameter des Modells verändert.
Der entscheidende Unterschied zum ersten Verfahren liegt in diesem letzten Schritt. Hier verändert sich tatsächlich etwas an dem, was das Modell danach kann, unabhängig von der einzelnen Aufgabe, an der es gerade gearbeitet hat.
Der eine entscheidende Unterschied
Beide Verfahren reagieren auf ein Ergebnis aus der realen Welt, eine Beobachtung oder ein Testergebnis. Nur eines der beiden nutzt dieses Ergebnis auch als Verifizierer für einen echten Lernschritt.
Bei ReAct bleibt die Beobachtung Teil des laufenden Gesprächs, nichts weiter. Bei RLEF wird das Ausführungsergebnis zum Verifizierer, der über Bestehen oder Durchfallen entscheidet, und dieses Urteil verändert über ein Parameter-Update das Modell selbst. Ein Modell, das mit RLEF trainiert wurde, bringt dieses gelernte Verhalten in jede künftige Aufgabe mit. Ein Modell, das nur mit ReAct arbeitet, bringt aus jeder erledigten Aufgabe nichts mit in die nächste.
Der Bankabgleich kennt das Prinzip längst
Nun zum ERP-System, das die meisten Leser dieses Blogs tatsächlich beschäftigt. SAP Business One verarbeitet Kontoauszüge automatisch, und dabei steckt ein Mechanismus, der auffällig an das erinnert, was eben beschrieben wurde.
Trifft das System beim ersten Abgleichsversuch nicht genug offene Transaktionen, die zu einer Kontoauszugsposition passen, bricht es nicht einfach ab. Es startet automatisch eine zweite Runde mit gelockerten Kriterien, und falls auch die nicht reicht, eine dritte, noch tolerantere Runde. Bis zu drei Abgleichsrunden, jede toleranter als die vorherige, ohne dass jemand manuell eingreifen müsste. Was am Ende einer erfolgreichen Runde entsteht, ist ein Buchungsvorschlag, der vor der endgültigen Buchung noch einmal geprüft werden kann.
Strukturell ist das fast exakt der ReAct-Loop von eben: ein Versuch, ein Ergebnis, ein angepasster nächster Versuch. Der Unterschied ist derselbe wie oben. Die drei Toleranzstufen sind fest programmiert, heute genauso wie vor einem Jahr, unabhängig davon, wie oft Runde zwei oder drei gebraucht wurde und wie zuverlässig sie am Ende trafen. Dass ein solcher Prüfmechanismus nicht automatisch ein lernendes System ist, wurde in dieser Reihe bereits am Beispiel des Genehmigungsprozesses in SAP Business One gezeigt. Ein Fail-Signal löst hier wie dort den nächsten Schritt aus. Nur wertet niemand aus, ob Runde zwei oder drei über die Zeit zuverlässiger trifft als beim letzten Mal.
Was wäre, wenn die Kaskade selbst dazulernen würde
An dieser Stelle folgt ein Gedankenexperiment. Die im Folgenden beschriebene Erweiterung ist bis jetzt nicht in SAP Business One enthalten, aber mit KI durchaus denkbar.
Die drei Toleranzstufen der Bankabgleichs-Kaskade könnten aus der eigenen Historie lernen, statt für alle Zeit fest zu stehen. Ein System, das nachverfolgt, welche Toleranzstufe bei welcher Art von Abweichung tatsächlich zum korrekten Treffer führte und welche zu einem falschen, lässt diese Erfahrung in die nächste Einstellung der Stufen einfließen. Runde zwei verwendet dann nicht mehr für alle Betragsabweichungen dieselbe feste Grenze. Sie fällt enger oder weiter aus, je nachdem, was sich in ähnlichen Fällen bislang als verlässlich erwiesen hat.
Damit bekäme die Kaskade genau das, was ihr laut obiger Beschreibung heute fehlt: einen echten Lernschritt, ähnlich dem Parameter-Update bei RLEF, nur bezogen auf die eigenen Toleranzgrenzen statt auf ein ganzes Sprachmodell.
Der Haken liegt in der Datenquelle. Ein solches System lernt nicht nur aus sorgfältig geprüften Treffern, sondern auch aus jenen Fällen, in denen jemand unter Zeitdruck einen unsicheren Treffer einfach durchgewunken hat. Ein einzelner nachlässiger Moment erschöpft sich dann nicht in einer einzelnen Buchung, sondern schreibt sich in die Einstellung künftiger Toleranzstufen ein, unbemerkt, bis jemand die Abweichung bewusst prüft.
Für wen sich das lohnt
Dieser Artikel richtet sich an Geschäftsführer und CFOs im Umfeld von SAP Business One, die einschätzen wollen, ob ein “lernendes” KI-Werkzeug tatsächlich dauerhaft dazulernt oder nur innerhalb der laufenden Sitzung reagiert, bevor sie entscheiden, wie viel Vertrauen sie einer solchen Automatisierung entgegenbringen.
Wer kein SAP Business One einsetzt, kann die Begriffsklärung zu ReAct und RLEF trotzdem mitnehmen, der ERP-Bezug fällt dann einfach weg. Und wer nach einer konkreten Kaufempfehlung für einen Coding-Assistenten oder ein KI-Automatisierungswerkzeug sucht, wird hier nicht fündig: Dieser Text schafft Begriffsklarheit, keine Produktentscheidung.
Der Bankabgleich in SAP Business One wird durch diesen Vergleich nicht klüger, seine drei Toleranzstufen bleiben, was sie sind. Aber wer weiß, dass “reagiert auf einen Fehler” und “lernt aus einem Fehler” zwei unterschiedliche Versprechen sind, hört beim nächsten Automatisierungs-Angebot genauer hin, welches der beiden gerade verkauft wird.

ReAct und RLEF: Wie Künstliche Intelligenz aus echten Fehlern lernt — und was der automatische Bankabgleich in SAP Business One damit zu tun hat
SAP B1 10.0 FP2608: Service Layer KI als transaktionalen Schicht
Process Reward Models: Warum ein richtiges Ergebnis noch keinen richtigen Weg beweist
Test-Time Compute Scaling: Warum ein kleineres KI-Modell am Ende gewinnen kann — und was der Lieferantenvergleich in SAP Business One damit zu tun hat
RLHF und Reward-Modelle: KI-Hype oder was der Genehmigungsprozess in SAP Business One damit zu tun hat