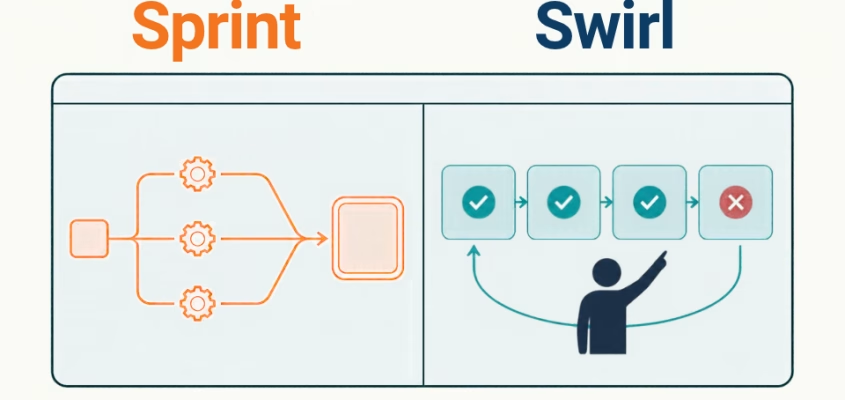
Diese Reihe beschäftigt sich mit Künstlicher Intelligenz im Zusammenspiel mit SAP Business One. Sie nimmt sich grundlegende KI-Prinzipien in Ruhe vor und spiegelt sie an einem Beispiel aus dem ERP-Alltag. Der vorige Beitrag über LATS zeigte, wie ein Modell beim Antworten mehrere Wege gleichzeitig durchdenkt. Diesmal geht es um zwei Verfahren, die früher ansetzen. Sprint und Swirl geben einem Sprachmodell nicht mehr Bedenkzeit beim Antworten. Sie bringen ihm schon im Training eine Arbeitsweise bei. Das eine lernt, Teilschritte gleichzeitig zu erledigen. Das andere lernt aus aufgezeichneten Probeläufen. Und auch hier gibt es schon Ansätze in SAP Business One, an die man andocken kann.
Weiterlesen: Sprint und Swirl: Wie ein KI-Agent Arbeit aufteilt und aus Probeläufen lerntEins nach dem anderen
Gründlich arbeitet, wer eins nach dem anderen erledigt. So lernt man es in der Ausbildung, und meistens stimmt es auch.
Soweit die ideale Welt. Wer jeden Schritt brav hinter den vorigen stellt, wartet nicht selten auf sich selbst. Die Angebotsanfrage an Lieferant B hängt nicht davon ab, was Lieferant A geantwortet hat. Trotzdem bleibt sie oft liegen, bis A sich gemeldet hat. Und wer nur aus echten Fehlern lernt, bezahlt jeden davon im laufenden Betrieb.
Für Sprachmodelle gilt dasselbe. Ein Sprachmodell schreibt seine Antwort Wort für Wort, eines nach dem anderen. Bei einer einfachen Frage reicht das völlig. Bei einer Aufgabe mit vielen Schritten wird diese Arbeitsweise zum Engpass. Jeder Schritt wartet auf den vorigen, auch wenn er ihn gar nicht braucht. Das Modell rechnet dann Teilaufgaben nacheinander durch, die sich ohne Weiteres gleichzeitig erledigen ließen.
Zwei Fragen, die jeder Projektleiter kennt
Das trifft vor allem auf Programme zu, die zum Beispiel Abfragen erstellen, Zahlen zusammenstellen oder eine Berechnung durchführen. Ein solcher Agent steht vor der Frage, was davon sich gleichzeitig erledigen lässt und was warten muss. Gleichzeitig stellt sich die Frage, wo das Modell üben soll, bevor es im echten System arbeitet.
Solche Fragen stellt man normalerweise dem Projektleiter. Die Forschung bringt Sprachmodellen also hier keine neue Fähigkeit bei, sondern Arbeitsorganisation. Das eine Verfahren lernt, unabhängige Teilschritte zu erkennen und gleichzeitig abzuarbeiten. Das andere lernt aus bewerteten Probeläufen, die es vorab aufgezeichnet hat. Beides kennt jeder, der schon einmal ein Projekt geleitet hat. Neu ist nur, dass eine Maschine es selbst lernt.
Eine Großküche und ein Lehrling
Eine Küchenchefin plant ein Menü für eine Feier. Die Kartoffeln kochen, während die Soße einreduziert. Das Dessert bereitet ein Kollege nebenher vor. Die Küchenchefin richtet erst an, wenn alle Teile fertig sind. Die eigentliche Kunst liegt dabei nicht im Kochen. Sie liegt im Wissen, was gleichzeitig gehen kann und was warten muss. Die Soße braucht den Bratensatz, also kommt sie nach dem Fleisch. Die Kartoffeln brauchen nichts außer Wasser und Zeit.
In derselben Küche lernt ein Lehrling. Er übt nicht am Abend der ausgebuchten Hochzeitsfeier. Er übt an aufgezeichneten Probedurchgängen. Die Ausbilderin geht diese Aufzeichnungen durch und bewertet jeden einzelnen Handgriff. Ob der Teller am Ende gelungen ist, spielt für diese Bewertung keine Rolle. Ein Probedurchgang mit sauberen Handgriffen bleibt lehrreich, auch wenn die Soße am Ende angebrannt ist.
Die Küchenchefin steht für das Verfahren Sprint, der Lehrling für Swirl. Beide Verfahren bringen einem Sprachmodell bei, Arbeit zu organisieren. Wie das technisch abläuft, zeigt der nächste Abschnitt.
Wie ein Modell lernt, Arbeit zu organisieren
Zwei Wege zu besseren Antworten
Ein Sprachmodell lässt sich auf zwei Arten zu besseren Ergebnissen bringen. Die erste Art setzt beim Antworten an. Das Modell bekommt mehr Rechenzeit und durchsucht viele mögliche Wege, bevor es sich festlegt. So arbeitet LATS aus dem vorigen Beitrag. Die zweite Art setzt früher an, nämlich im Training. Dort lernt das Modell eine Struktur, die es später von sich aus anwendet.
Sprint und Swirl gehören zur zweiten Art. Sie nutzen zwei bekannte Lernverfahren. Beim Supervised Fine-Tuning lernt ein Modell anhand vorgegebener Beispiele, vergleichbar mit einem Kochlehrling, der die Gerichte seiner Meisterin nachkocht. Beim Reinforcement Learning (Lernen über Belohnung) probiert das Modell selbst (in der Versuchsküche) etwas aus und erhält für jede Handlung eine Rückmeldung. Gute Handlungen verstärkt es, schlechte lässt es künftig eher sein. Ihre Trainingsdaten erzeugen beide Verfahren selbst, statt sie von Menschen schreiben zu lassen.
Sprint: unabhängige Schritte gleichzeitig
Sprint stammt aus der Forschungsarbeit “SPRINT: Enabling Interleaved Planning and Parallelized Execution in Reasoning Models” aus dem Jahr 2025. Den Kern bildet ein sogenannter DAG (Directed Acyclic Graph, auf Deutsch gerichteter azyklischer Graph). Das klingt sperriger, als es ist. Gemeint ist eine Landkarte der Abhängigkeiten: Welcher Denkschritt braucht das Ergebnis welches anderen? Schritte ohne gegenseitige Abhängigkeit bilden parallele Pfade, wie Kartoffeln und Dessert in der Küche. Das Verfahren läuft in drei Phasen ab:
- Daten aufbereiten: Ein großes Sprachmodell nimmt lange, ausführliche Denkwege eines starken Modells und zerlegt sie in einzelne Schritte. Es kennzeichnet, welcher Teil Planung und welcher Ausführung ist, und leitet daraus die Landkarte der Abhängigkeiten ab.
- Feintuning: Ein Basismodell lernt per Supervised Fine-Tuning an diesen aufbereiteten Beispielen. Es lernt dabei, unabhängige Pläne gleichzeitig auszugeben, jeden mit einer eigenen Kennzeichnung.
- Anwendung: Bei einer neuen Frage erzeugt das Modell mehrere unabhängige Pläne auf einmal. Diese laufen parallel ab, etwa als Werkzeugaufrufe oder Berechnungen. Die Ergebnisse fließen gesammelt in den Kontext zurück. Danach folgt eine neue Planrunde oder die abschließende Antwort.
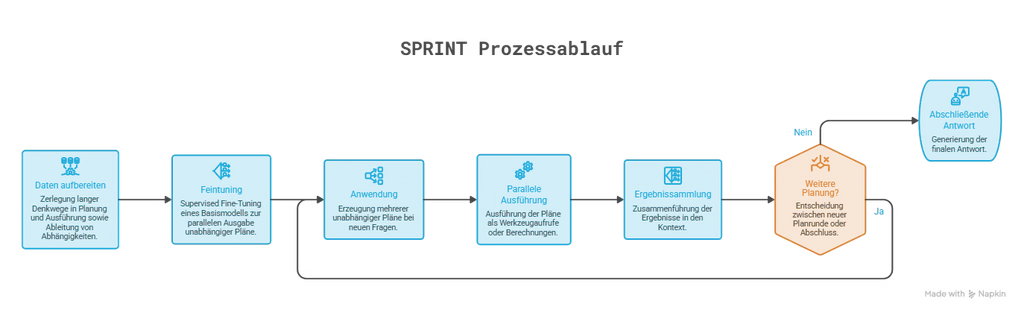
Entscheidend ist die dritte Phase. Das Modell plant nicht einmal am Anfang und arbeitet dann stur ab. Es wechselt zwischen Planen und Ausführen hin und her. Nach jeder parallelen Runde weiß es mehr und plant die nächste Runde auf dieser Grundlage.
Swirl: lernen aus Probeläufen
Swirl steht für Step-Wise Reinforcement Learning, also schrittweises Lernen über Belohnung. Das Verfahren stammt aus der Forschungsarbeit “Synthetic Data Generation & Multi-Step RL for Reasoning & Tool Use” aus dem Jahr 2025. Es läuft in vier Phasen ab:
- Probeläufe erzeugen: Das Modell bearbeitet eine Frage Schritt für Schritt. Jeder Schritt besteht aus einer Überlegung und einem Werkzeugaufruf, etwa einer Suche oder einer Rechnung. Das Werkzeug läuft dabei tatsächlich, allerdings in einer eigenen Übungsphase vor dem Training. Ein zweites Sprachmodell bewertet als Richter jeden einzelnen Schritt. Das Ergebnis des Werkzeugaufrufs kennt der Richter dabei nicht.
- Daten filtern: Aus den bewerteten Probeläufen entstehen verschiedene Trainingsdatensätze. Der prozessgefilterte enthält Läufe, deren Einzelschritte gut bewertet sind, gleich wie das Endergebnis ausfällt. Der ergebnisgefilterte enthält nur Läufe mit richtigem Endergebnis. Ein dritter verlangt beides, ein vierter wählt zufällig aus.
- Trainieren ohne laufende Werkzeuge: Das Modell bekommt einen Ausschnitt eines Probelaufs und schlägt den nächsten Schritt vor. Die Belohnung dafür liest das Training aus den vorab gespeicherten Bewertungen. Kein Werkzeug muss dafür erneut laufen.
- Anwendung: Im Einsatz ruft das Modell seine Werkzeuge wieder selbst auf, Schritt für Schritt und nur bei Bedarf.
Der Clou liegt in der Trennung. Probeläufe erzeugen und bewerten geschieht einmal, vorab. Das eigentliche Lernen greift danach nur noch auf diese Aufzeichnungen zurück. Ein früherer Beitrag dieser Reihe beschrieb mit ReAct und RLEF, wie Künstliche Intelligenz aus echten Fehlern lernt. Swirl lernt dagegen aus aufgezeichneten Fehlern und Erfolgen.
Process Rewards: der zweite Auftritt
Ein früherer Beitrag dieser Reihe hat sich mit Process Reward Models beschäftigt. Dort ging es um die Frage, ob ein richtiges Ergebnis auch einen richtigen Weg beweist. Swirl führt diese Frage einen Schritt weiter. Taugt ein Lauf mit falschem Endergebnis als Lernmaterial, wenn seine Einzelschritte gut waren?
Die Antwort hängt vom Lernverfahren ab. Beim Lernen über Belohnung schneidet der prozessgefilterte Datensatz besser ab als der ergebnisgefilterte und auch besser als der kombinierte. Swirl lernt also ausdrücklich auch aus Läufen, die am Ende danebenlagen. Die Begründung überrascht zunächst, leuchtet aber ein. Läufe mit richtigem Ergebnis zeigen nur, was das Modell ohnehin schon kann. Lernen soll es aber gerade die Aufgaben, an denen es bisher scheitert. Beim Lernen über Belohnung bekommt es an jedem Einzelschritt eine neue Chance. So lernt es, aus einem fehlerhaften Gesamtablauf auszubrechen.
Beim Supervised Fine-Tuning ist es umgekehrt. Wer nachahmt, ahmt auch Fehler nach. Dort braucht das Modell Läufe, bei denen Weg und Ergebnis stimmen. Läufe mit falschem Ergebnis können ihm sogar schaden. Insgesamt schneidet das schrittweise Lernen über Belohnung deutlich besser ab als das Nachahmen.
Was beide verbindet
Beide Verfahren zeigen eine Eigenschaft, die über bessere Planung hinausgeht. Sie übertragen das Gelernte auf Aufgaben, die im Training gar nicht vorkamen. Der Fachbegriff dafür lautet Out-of-domain Generalization.
Sprint lernte das parallele Denken ausschließlich an Mathematikaufgaben. Bei zwei anderen Aufgabentypen, die es im Training nie gesehen hatte, arbeitete es danach ebenfalls paralleler und genauer. Swirl lernte an Rechenaufgaben mit Taschenrechner und wurde anschließend besser bei Rechercheaufgaben mit Suchwerkzeug. Umgekehrt funktionierte es ebenso. Die Qualität der Einzelschritte stieg dabei innerhalb und außerhalb der Trainingsaufgaben.
Das Modell lernt hier offenbar mehr als den Umgang mit einem bestimmten Werkzeug. Es lernt, in Schritten zu denken und Werkzeuge gezielt aufzurufen. Das ist Arbeitsorganisation im eigentlichen Sinn.
Planung in SAP Business One: das Prinzip ohne Lernen
In SAP Business One gibt es einige Planungswerkzeuge. Als exemplarisch können da zum Beispiel Teilprojekte oder der Dispositionsassistent gelten. Das eine gehört zum Projektmanagement, das andere zur Materialbedarfsplanung. Beide organisieren Arbeit nach einem ähnlichen Muster wie Sprint und Swirl. Allerdings: Keines von beiden lernt dabei.
Teilprojekte: zerlegen, nebeneinander arbeiten, zusammenführen
Im Projektmanagement von SAP Business One lässt sich ein Projekt auf einer eigenen Registerkarte in Teilprojekte gliedern. Im Hauptprojekt erscheinen Budget und Gewinn kumuliert, also als Summe über die Teilprojekte. Das ähnelt dem Ablauf, den Sprint in der Anwendungsphase durchläuft: eine große Aufgabe zerlegen, die Teile nebeneinander bearbeiten, die Ergebnisse zusammenführen.
Der Vergleich endet an drei Stellen:
- Welche Teilprojekte es gibt, legt ein Mensch beim Anlegen des Projekts fest. Sprint lernt dagegen, die Abhängigkeiten zwischen Schritten selbst zu erkennen.
- Die Gleichzeitigkeit ist in SAP Business One organisatorisch. Teams arbeiten nebeneinander, das System rechnet nicht parallel.
- Die Kumulierung im Hauptprojekt ist ein Endstand. Nach ihr beginnt keine neue Planrunde, wie Sprint sie nach jeder Zusammenführung einlegt.
Der Dispositionsassistent rechnet vor und lässt entscheiden
In der Materialbedarfsplanung rechnet der Dispositionsassistent den Bedarf durch. Er arbeitet dabei getrennt vom Tagesgeschäft und speichert sein Ergebnis als Vorschlag. Erst in der Auftragsempfehlung prüft der Disponent diese Vorschläge. Er passt sie an und wandelt sie bei Bedarf in Bestellungen bei Lieferanten oder in Produktionsaufträge um.
Das ist die Trennung, die auch Swirl kennzeichnet: erst rechnen und ablegen, später prüfen und verwenden. Die Berechnung läuft einmal. Die spätere Verwendung greift auf ihr gespeichertes Ergebnis zurück.
Auch hier endet der Vergleich deutlich. Der Dispositionsassistent bewertet keinen einzelnen Rechenschritt. Er sortiert seine Vorschläge nicht nach der Qualität des Weges oder des Ergebnisses. Und er lernt nicht aus dem, was der Disponent mit einem Vorschlag macht. Beide Werkzeuge organisieren Planung. Keines von beiden lernt aus ihr.
Gedankenexperiment: Planung, die aus eigenen Vorschlägen lernt
Was jetzt folgt, ist ein Gedankenexperiment, keine Ankündigung. Die beschriebene Erweiterung ist bis jetzt nicht in SAP Business One enthalten, aber mit Künstlicher Intelligenz durchaus denkbar.
Teilprojekte, die ihre Abhängigkeiten selbst erkennen
Beim Anlegen eines neuen Projekts schlägt eine lernende Komponente eine Gliederung vor. Sie leitet aus früheren Projekten ab, welche Teilaufgaben unabhängig voneinander laufen können und welche aufeinander warten müssen. Die Montage wartet auf die Lieferung, die Schulung der Anwender nicht unbedingt. Der Projektleiter sieht den Vorschlag als Landkarte der Abhängigkeiten und entscheidet, was er übernimmt. Nach jedem abgeschlossenen Abschnitt gleicht die Komponente den Plan mit dem tatsächlichen Stand ab und schlägt die nächste Runde vor, ganz im Sinne von Sprint.
Disposition, die aus dem Archiv ihrer Vorschläge lernt
Angenommen, das System hielte zu jeder Auftragsempfehlung fest, was der Disponent daraus gemacht hat: übernommen, geändert oder verworfen. Ein solches Archiv wäre eine Sammlung von Probeläufen im Sinne von Swirl. Eine Richter-Instanz bewertet darin jeden Planungsschritt einzeln, etwa eine Annahme zur Lieferzeit oder zur Bestellmenge. Der spätere Lagerbestand allein entscheidet nicht über gut oder schlecht.
Das Lernen läuft offline, ohne den laufenden Mandanten anzufassen. Dabei gilt die Lehre aus Swirl: Auch ein Vorschlag, der am Ende in einen Engpass führte, enthält gute Einzelschritte. Die Komponente lernt aus diesen Schritten, statt den ganzen Vorschlag zu verwerfen. Der Disponent erhält so Vorschläge, die mit jeder Planungsrunde etwas besser zu seinem Betrieb passen.
Der Haken
Wie immer gibt es Haken und Ösen, die man auf dem Schirm haben muss. Das erste Risiko steckt in der Zusammenführung. Eine falsch angenommene Unabhängigkeit führt dazu, dass parallel geplante Teilschritte sich widersprechen. Die Zusammenführung bemerkt nur, was sie sieht. Zwei Teilprojekte, die unbemerkt auf dieselbe Ressource zugreifen, fallen erst auf, wenn es zu spät ist.
Das zweite Risiko steckt im Richter. Er bewertet einen Schritt, ohne dessen Ausgang zu kennen. Ein plausibel aussehender, aber falscher Planungsschritt erhält deshalb womöglich eine gute Note. Ein Archiv voller solcher Noten bringt dem System dann mit großer Sorgfalt das Falsche bei.
Für wen sich das lohnt
Dieser Beitrag wendet sich an alle, die verstehen wollen, warum ein KI-Agent mehr ist als eine schnellere Textausgabe. Gemeint ist ein Programm, das seine Arbeit selbst organisiert.
Wer weder das Projektmanagement noch die Materialbedarfsplanung in SAP Business One nutzt, findet im Beispiel wenig Anschluss an die eigene Praxis. Die Begriffsklärung zu Sprint und Swirl kann er trotzdem mitnehmen. Dieser Text schafft Begriffsklarheit, keine Entscheidungsvorlage.
Gleichzeitig arbeiten und aus Probeläufen lernen konnten gute Projektleiter und Disponenten schon immer. Neu ist, dass ein Modell beides aus Daten lernt, statt es im Einzelfall gesagt zu bekommen. Ganz ohne Maßstab geht es trotzdem nicht: Irgendjemand muss dem Richter sagen, was ein guter Schritt ist. Wer das für die eigenen Prozesse nicht weiß, wird es auch keiner Maschine beibringen.

Sprint und Swirl: Wie ein KI-Agent Arbeit aufteilt und aus Probeläufen lernt
LATS: Mehrere Wege gleichzeitig durchdenkt mit KI — und die Verfügbarkeitsprüfung in SAP B1

ReAct und RLEF: Wie Künstliche Intelligenz aus echten Fehlern lernt — und was der automatische Bankabgleich in SAP Business One damit zu tun hat
SAP B1 10.0 FP2608: Service Layer KI als transaktionalen Schicht
Process Reward Models: Warum ein richtiges Ergebnis noch keinen richtigen Weg beweist